Il capitolo in un paragrafo. Senza memoria né orologio comuni, coordinarsi significa scambiarsi messaggi che portano con sé ciò che il mittente sa degli altri. La mutua esclusione si ottiene con un coordinatore che rispetta l'ordine causale delle richieste oppure, con Ricart–Agrawala, chiedendo il permesso a tutti. Chang–Roberts elegge un leader su un anello; matrici di contatori garantiscono l'ordine causale dei messaggi; Chandy–Lamport fotografa uno stato globale consistente senza fermare nessuno. Il consenso è il problema centrale: impossibile in un sistema asincrono con anche un solo crash (FLP), risolvibile in uno sincrono, anche con traditori purché siano meno di un terzo.
1. Come si legge un algoritmo distribuito
Le sfide sono le tre assenze del capitolo 17: niente clock condiviso, niente memoria condivisa, guasti. L'idea generale è usare la relazione happened-before e gli orologi logici per ordinare gli eventi che sono in relazione. Le ipotesi sul sistema dipendono dal problema:
la maggior parte degli algoritmi assume un sistema asincrono ma senza guasti: ogni messaggio arriva, in un tempo finito ma non noto a priori;
quando si devono gestire i guasti si assume un sistema sincrono, in cui i timeout sono affidabili.
Le slide, seguendo Coulouris, dividono gli algoritmi distribuiti in cinque categorie:
ordinamento (parziale) degli eventi: orologi logici e vettoriali, usati da tutti gli altri;
osservazione dello stato: snapshot globali;
coordinamento e accordo: mutua esclusione distribuita, elezione, comunicazione multicast, consenso;
transazioni distribuite e controllo della concorrenza;
replica e servizi tolleranti ai guasti.
Il corso vede la mutua esclusione (centralizzata e Ricart–Agrawala), l'elezione (Chang–Roberts), l'ordinamento causale e totale dei messaggi, lo snapshot di Chandy–Lamport e il problema del consenso.
Due chiavi di lettura valgono per tutti. La prima è la propagazione della conoscenza: ogni messaggio porta, oltre al contenuto, ciò che il mittente sa degli altri processi (un vettore, dei contatori, una matrice). Chi riceve aggiorna la propria conoscenza e può accorgersi di un «buco»: qualcosa che deve essere già successo altrove ma non gli è ancora arrivato. Se nessuna catena di messaggi collega due eventi, sono concorrenti e l'algoritmo non impone alcun ordine tra loro. La seconda è la topologia, come nel problema dello scambio di valori del capitolo 14: un coordinatore centrale (semplice, ma un unico punto di guasto e un collo di bottiglia), un anello logico (meno messaggi) oppure uno schema del tutto decentralizzato e simmetrico.
Per l'esame
Ricci ha detto che all'orale, sugli algoritmi distribuiti, chiede come funzionano e quali tipi esistono, per esempio per la mutua esclusione. Non chiede dimostrazioni di teoremi: conta saper raccontare il meccanismo e perché funziona.
2. Mutua esclusione con un coordinatore
Il problema è quello del capitolo 4, ma i processi sono distribuiti: niente semafori né lock, solo messaggi. Le proprietà richieste diventano:
safety: due processi non hanno mai il permesso di stare in sezione critica (CS) nello stesso momento;
liveness: ogni richiesta di entrare in CS prima o poi viene soddisfatta;
fairness: le richieste vengono soddisfatte nell'ordine in cui sono fatte, cioè secondo happened-before.
La soluzione più semplice è asimmetrica: un coordinatore P0 custodisce un token, il permesso di entrare. Chi vuole entrare invia una richiesta a P0 ed entra quando riceve il token; uscendo lo restituisce. Sono tre messaggi per ogni ingresso: richiesta, token, rilascio. Se P0 riceve una richiesta mentre il token è fuori, non risponde «no», perché costringerebbe a riprovare: accoda la richiesta e risponde quando il token torna. È lo schema che ritroveremo in tutti gli algoritmi: le risposte si ritardano, non si negano.
Il problema della fairness
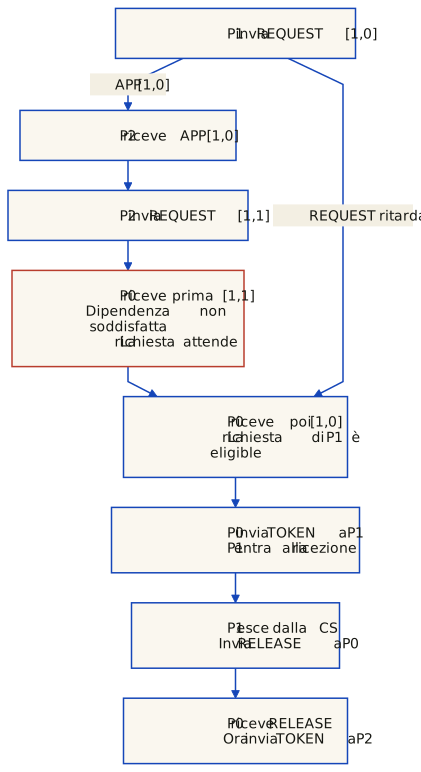
Un coordinatore che serve le richieste in ordine di arrivo non è fair. P1 invia la sua richiesta a P0 e poi un messaggio applicativo a P2; P2, dopo averlo ricevuto, invia la sua richiesta. La richiesta di P1 è avvenuta prima (happened-before) di quella di P2, ma la rete può consegnare a P0 prima quella di P2. P0 dovrebbe aspettare, ma come fa a sapere che esiste una richiesta di P1 ancora in viaggio? Solo se l'informazione gli arriva con il messaggio di P2.
Ogni processo tiene quindi un vettore v, dove v[j] è il numero di richieste di Pj che gli sono note, e lo allega (piggybacking) a ogni messaggio, anche a quelli applicativi. Chi riceve fa il massimo componente per componente. Non è un orologio vettoriale che conta tutti gli eventi, ma lo stesso principio applicato alle sole richieste. Nell'esempio P1 invia [1,0]; P2, che ha ricevuto quel vettore con il messaggio applicativo, invia [1,1]. Quando [1,1] arriva, P0 non ha ancora servito nessuna richiesta di P1, quindi sa che ce n'è una pendente e aspetta.
Fig. 1 — La richiesta [1,1] arriva prima ma dichiara di conoscere una richiesta di P1 non ancora servita: P0 la tiene in coda finché [1,0] non arriva ed è servita.
Il coordinatore mantiene reqList, le richieste ricevute e non ancora soddisfatte, e reqDone[i], il numero di richieste di Pi già soddisfatte (cioè a cui ha inviato il token). Una richiesta w di Pp è eligible se è la prossima di Pp e non esiste una richiesta che la precede causalmente e non è ancora stata soddisfatta:
Client Pi                                   Coordinatore P0
v: array[1..N] := 0                         reqDone: array[1..N] := 0
                                            reqList := [];  haveToken := true
richiesta:
  v[i] := v[i] + 1                          on (REQ, w) da Pp:
  send (REQ, v) to P0                         append(reqList, w)
on TOKEN:  entra in CS                        if haveToken: checkReq()
rilascio:  esci; send (RELEASE, v) to P0    on RELEASE:
on ogni messaggio u:  v := max(v, u.v)        haveToken := true; checkReq()

checkReq():
  eligible := { w in reqList | w.v[p] = reqDone[p] + 1  e  w.v[j] <= reqDone[j] per ogni j != p }
  if eligible non è vuoto:
    w := first(eligible); delete(reqList, w)
    reqDone[p] := reqDone[p] + 1; haveToken := false
    send TOKEN to Pp
Per gli altri processi la condizione è ≤, come dice la spiegazione delle slide («w.v è al più reqDone»), mentre lo pseudocodice della slide 10 scrive ==. Con l'uguaglianza l'algoritmo si blocca su richieste concorrenti: P1 richiede con [1,0], P2 con [0,1] senza sapere nulla di P1. Dopo aver servito P1, reqDone = [1,0], e la richiesta di P2 avrebbe 0 ≠ 1 sulla componente di P1: non diventerebbe mai eligible.
Simulatore: il coordinatore causale
Crea richieste, invia messaggi applicativi tra i client e scegli tu l'ordine di consegna. P0 decide da solo quando riceve una richiesta o un rilascio; una richiesta eligible aspetta comunque che il token sia tornato.
Il simulatore richiede JavaScript.
Il limite dell'approccio è il coordinatore: è un unico punto di guasto e un collo di bottiglia. Per tollerarne il crash, la richiesta deve ricevere una conferma entro un timeout; se la conferma manca, si assume che il coordinatore sia caduto e se ne elegge un altro (sezione 4).
3. Ricart–Agrawala: mutua esclusione senza coordinatore
Ricart e Agrawala (1981) eliminano il coordinatore: per entrare in CS un processo chiede il permesso a tutti gli altri. Invia a ciascuno una richiesta con un timestamp logico ed entra solo dopo aver ricevuto OK da tutti gli N − 1. Quando riceve una richiesta, un processo si comporta così:
non è interessato alla CS: risponde subito OK;
è in CS: non risponde, e mette il richiedente in una coda di attesa (pendingQ);
ha anche lui una richiesta pendente: confronta le richieste. Se quella ricevuta ha priorità, cioè una coppia (timestamp, id) minore, risponde OK; altrimenti la accoda.
Uscendo dalla CS invia OK a tutti i processi in coda. Non si crea un problema di mutua esclusione, perché ognuno di loro deve comunque raccogliere gli OK di tutti gli altri prima di entrare.
P[i]::
  pendingQ := [];  myreq := ∞;  numOK := 0      -- myreq = ∞: non interessato

richiesta:
  myreq := (logical_clock, i);  numOK := 0
  send (REQ, myreq) a tutti gli altri processi

on (REQ, r) da Pj:              -- il clock logico si aggiorna come sempre
  if r < myreq  then send OK a Pj        -- confronto lessicografico su (timestamp, id)
  else append(pendingQ, j)

on OK:
  numOK := numOK + 1
  if numOK = N − 1 then entra in CS

rilascio:
  myreq := ∞
  for each j in pendingQ: send OK a Pj
  empty(pendingQ)
Nello pseudocodice i tre casi diventano un solo confronto. Chi non è interessato ha myreq = ∞, quindi risponde sempre. Chi è in CS tiene myreq finché non esce, e qualunque richiesta arrivi nel frattempo ha una coppia maggiore: il richiedente ha dovuto dargli OK, e con gli orologi di Lamport una richiesta fatta dopo aver visto la sua ha un timestamp più grande. L'identificatore rompe le parità tra timestamp uguali (la slide confronta solo i timestamp).
Mutua esclusione. Se Pi e Pj fossero entrambi in CS, ognuno avrebbe ricevuto l'OK dell'altro. Ma tra due richieste pendenti chi ha la coppia maggiore dà OK e chi ha la minore lo differisce fino all'uscita: i due OK non possono esserci entrambi.
Niente deadlock né starvation. Le coppie (timestamp, id) sono totalmente ordinate: la richiesta pendente minore riceve OK da tutti. Le richieste vengono servite nell'ordine dei timestamp, coerente con happened-before.
Costo.2(N − 1) messaggi per ogni ingresso: N − 1 richieste e N − 1 OK. Non serve che i canali siano FIFO.
Il prezzo della simmetria è che ogni processo deve conoscere tutti gli altri e che il guasto di uno qualsiasi blocca chi aspetta il suo OK: i punti di guasto passano da uno a N. Per ridurre i messaggi si può usare una soluzione intermedia su un anello logico, come nello scambio di valori.
Per l'esame
«Come si realizza una sezione critica in modo completamente decentralizzato?» è una domanda che Ricci ha fatto. Risposta: con Ricart–Agrawala. Il richiedente invia a tutti una richiesta con timestamp; un processo risponde OK subito, a meno che sia in CS oppure stia a sua volta richiedendo con una coppia (timestamp, id) minore; in quei casi differisce l'OK e lo invia all'uscita dalla CS. Si entra con N − 1 OK, per un totale di 2(N − 1) messaggi.
Simulatore: Ricart–Agrawala con tre processi
Genera le richieste e scegli quale messaggio in transito consegnare. Prova a far richiedere P1 e P3 prima di consegnare qualunque messaggio: i timestamp coincidono e l'identificatore decide a favore di P1, che differisce l'OK a P3 fino al proprio rilascio.
Il simulatore richiede JavaScript.
4. Elezione del leader: Chang–Roberts
Un leader è un processo scelto tra N per svolgere un compito particolare, per esempio fare da coordinatore di un algoritmo centralizzato. Fissarlo a priori non basta, perché può cadere: servono algoritmi che lo eleggano, e lo rieleggano quando ci si accorge che il leader non risponde. Tipicamente si sovrappone alla rete una topologia logica ad anello, in cui ogni processo conosce il proprio vicino.
Nell'algoritmo di Chang e Roberts (1979) ogni processo ha un identificatore unico e vince il massimo. Uno o più processi possono avviare l'elezione spontaneamente, anche contemporaneamente.
Chi avvia invia election(myid) al vicino e diventa partecipe (awake).
Chi riceve election(j) con j maggiore del proprio id lo inoltra, e diventa partecipe. Se j è minore e non ha ancora partecipato, lo sostituisce con il proprio id; se ha già partecipato, lo scarta.
Chi riceve il proprio id ha visto la sua candidatura fare il giro completo senza incontrare id maggiori: si proclama leader e fa girare leader(myid), che tutti registrano e inoltrano fino al ritorno al leader.
P[i]::  myid;  awake := false;  leaderId := null

avvio dell'elezione:
  send (election, myid) al vicino;  awake := true

on (election, j):
  if j > myid then send (election, j) al vicino; awake := true   -- inoltra e partecipa
  else if j = myid then send (leader, myid) al vicino       -- la mia candidatura è tornata
  else if j < myid and not awake then
    send (election, myid) al vicino;  awake := true         -- mi candido al posto di j
                                                            -- altrimenti: scarta j

on (leader, j):
  leaderId := j
  if j != myid then send (leader, j) al vicino
Poiché ogni candidatura minore viene fermata dal primo processo con id maggiore, solo quella del massimo torna al suo autore: il risultato non cambia se più processi avviano l'elezione insieme.
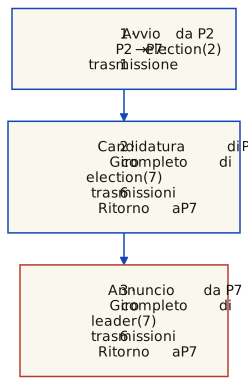
Il costo dipende da quanti avviano. Con un solo iniziatore, nel caso peggiore la candidatura impiega N − 1 passi per raggiungere il massimo, e quella del massimo N passi per tornargli: 2N − 1 messaggi election, più N messaggi leader. È il conteggio delle slide, che vale però solo con un iniziatore. Se tutti avviano e gli id decrescono nel verso dell'anello, le candidature percorrono 1 + 2 + … + N archi: N(N + 1)/2 messaggi election, cioè O(N²).
Fig. 2 — Anello P2 → P7 → P3 → P1 → P5 → P4 → P2, con P2 unico iniziatore: 7 messaggi election e 6 leader, 13 in tutto. Il simulatore riproduce questa esecuzione.
L'algoritmo non gestisce i guasti: se un processo dell'anello cade, qualcuno deve accorgersene (timeout) e ricostruire l'anello senza di lui. È un problema ortogonale all'elezione vera e propria.
Simulatore: l'elezione passo per passo
Avvia da P2 per rivedere le 13 trasmissioni della figura, poi reimposta e prova ad avviare da più processi insieme.
Il simulatore richiede JavaScript.
5. Ordinare i messaggi
In una computazione completamente asincrona i messaggi possono arrivare in qualsiasi ordine: massimo non determinismo, massima concorrenza. Spesso conviene ridurre il non determinismo restringendo gli ordini possibili. Le garanzie principali, dalla più debole:
Ordinamento
Garanzia
FIFO
i messaggi di uno stesso mittente verso uno stesso destinatario sono ricevuti nell'ordine di invio
Causale
se send(m1) → send(m2), ogni destinatario comune riceve m1 prima di m2 («nessun sorpasso»)
Totale (multicast)
tutti i processi ricevono i messaggi nello stesso ordine: se P riceve x prima di y, nessun Q riceve y prima di x
Sincrono
tutti i messaggi si comportano come se l'invio fosse istantaneo
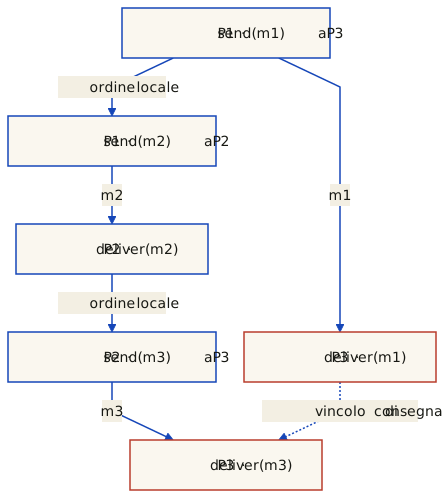
L'ordine causale include il FIFO, ma non viceversa. Esempio: P1 invia m1 a P3, poi m2 a P2; P2, ricevuto m2, invia m3 a P3. La catena send(m1) → send(m2) → receive(m2) → send(m3) obbliga P3 a ricevere m1 prima di m3, anche se m3 arriva prima. Il FIFO non lo vieta, perché m1 e m3 hanno mittenti diversi: è la stessa situazione degli attori di Pekko, che garantiscono solo l'ordine per coppia (capitolo 15). L'ordine totale è un'altra dimensione: due messaggi concorrenti possono arrivare in ordini diversi a due processi senza violare la causalità, ma violando l'ordine totale.
Fig. 3 — L'arco tratteggiato non è un messaggio: è il vincolo che la catena causale impone alla consegna presso P3.
L'algoritmo con la matrice
Per garantire l'ordine causale ogni processo Pi tiene una matrice N × N, estensione degli orologi vettoriali: m[j,k] è il numero di messaggi inviati da Pj a Pk per quanto noto a Pi. La riga j dice che cosa ha inviato Pj, la colonna k che cosa è stato inviato a Pk. A ogni invio da Pi a Pj si incrementa m[i,j] e si allega l'intera matrice. All'arrivo, il middleware non consegna subito il messaggio all'applicazione: controlla prima che sia eligible, guardando solo la propria colonna.
Pi::  m: array[1..N,1..N] := 0

invio a Pj:
  m[i,j] := m[i,j] + 1
  allega m al messaggio

arrivo da Pj con matrice m':
  eligible se  m'[j,i] = m[j,i] + 1              -- è il prossimo messaggio atteso da Pj
         e     m'[k,i] <= m[k,i] per ogni k != j  -- i messaggi per me che lo precedono sono già consegnati
  se non eligible: tienilo nel buffer
  altrimenti: m := max(m, m'); consegnalo; ricontrolla i messaggi nel buffer
Nell'esempio, m3 arriva a P3 con una matrice che dice «P1 ha già inviato un messaggio a P3». La colonna di P3 dice che non ne ha ancora ricevuto nessuno: c'è un buco, e m3 resta nel buffer. Quando arriva m1 viene consegnato, e subito dopo anche m3. Se invece P2 non avesse ricevuto m2, i due invii sarebbero concorrenti e P3 potrebbe consegnarli in qualsiasi ordine. Anche qui la slide scrive == per le righe k ≠ j, mentre la spiegazione dice «minore o uguale»: serve ≤, perché P3 può aver già consegnato messaggi concorrenti che il mittente non conosce, e con l'uguaglianza li aspetterebbe per sempre.
Simulatore: arrivo, buffer e consegna
Gli scenari mostrano il sorpasso causale, due messaggi concorrenti, il ripristino del FIFO per uno stesso mittente e un collegamento avvenuto troppo presto per creare causalità.
Il simulatore richiede JavaScript.
Sincronizzatori
Progettare un algoritmo è più facile se si assume una rete sincrona. I sincronizzatori la simulano sopra una rete asincrona, assumendo assenza di guasti o un ritardo massimo noto. Un pulse è un contatore in ogni processo con la proprietà che ogni messaggio inviato al pulse i è ricevuto al pulse i; un sincronizzatore è il meccanismo che dice a un processo quando può generare il pulse successivo. Nello schema più semplice ogni processo invia esattamente un messaggio a ciascun vicino a ogni pulse, e se riceve un messaggio del pulse i + 1 mentre è ancora al pulse i lo mette da parte:
Pj::  pulse := 0
round i:
  pulse := pulse + 1
  simula il round i dell'algoritmo sincrono
  send msg con pulse a tutti i vicini
  attendi esattamente un messaggio con pulse = i da ogni vicino
Il costo si misura in complessità in messaggi, i messaggi aggiuntivi per simulare l'algoritmo sincrono, e in complessità in tempo, le unità di tempo per simulare un pulse, dove un'unità è il tempo di un messaggio asincrono.
6. Lo stato globale: tagli consistenti e Chandy–Lamport
Molte domande riguardano lo stato globale: il sistema è in deadlock? Tutti i processi hanno terminato? La somma dei valori supera una soglia? Ma non esiste un istante t in cui leggere tutti gli stati locali. Per molte applicazioni basta catturare uno stato globale che si è verificato nel passato, purché sia coerente. Un algoritmo che lo fa si chiama algoritmo di snapshot globale.
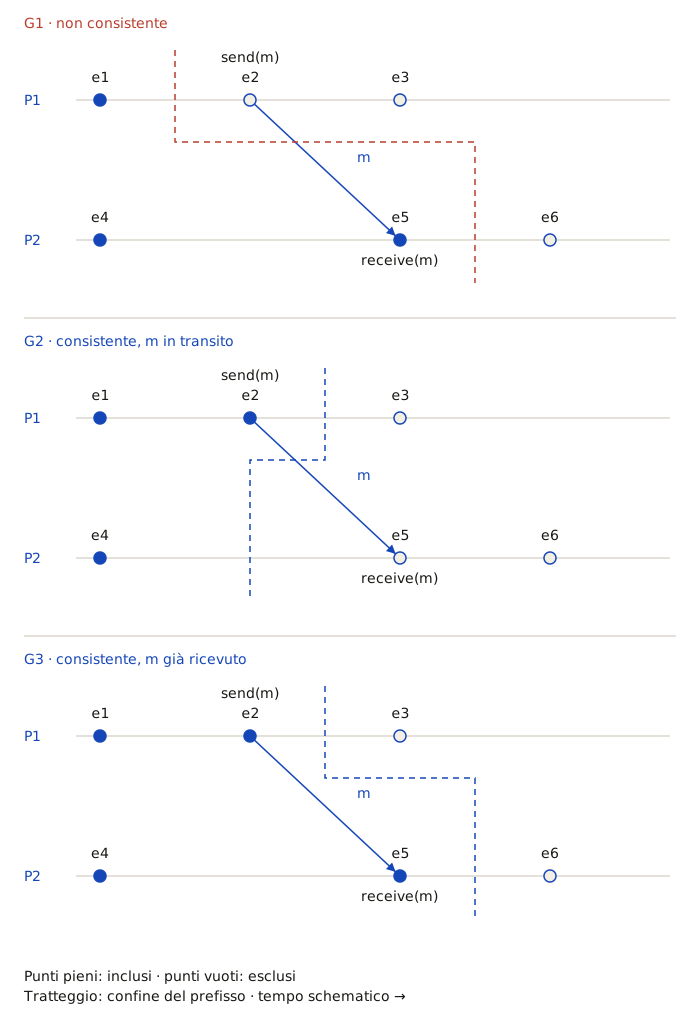
Uno stato globale è un insieme di stati locali, uno per processo, tutti concorrenti tra loro, più lo stato dei canali. Non basta prendere uno stato qualsiasi per processo: bisogna che nessuno stato «veda» l'effetto di un evento che, nello stesso taglio, non è ancora avvenuto. Operativamente, un taglio sceglie un prefisso degli eventi di ogni processo, ed è consistente se per ogni messaggio m: se il taglio contiene receive(m), contiene anche send(m). Se contiene send(m) ma non receive(m), il messaggio era in viaggio e fa parte dello stato del canale.
Fig. 4 — G1 = {e1, e4, e5} registra una ricezione il cui invio è nel futuro di P1: non è consistente. G2 = {e1, e2, e4} è consistente con m nel canale; G3 = {e1, e2, e4, e5} è consistente con il canale vuoto.
Il selettore dei tagli richiede JavaScript.
Fotografare senza fermare tutti
Un protocollo banale esiste: un processo avvisa tutti, ognuno conferma e smette di modificare il proprio stato, poi tutti inviano lo stato. Funziona, ma blocca l'intero sistema. La sfida di Chandy e Lamport (1985) è ottenere uno snapshot consistente senza bloccare i processi, catturando anche i messaggi in volo. L'ipotesi è che i canali siano unidirezionali e FIFO.
Ogni processo ha un colore: all'inizio sono tutti bianchi. Lo snapshot è lo stato del sistema appena prima che ciascun processo diventi rosso.
Un processo che decide di avviare lo snapshot salva il proprio stato locale, diventa rosso e invia un marker su tutti i canali in uscita, prima di qualsiasi altro messaggio.
Un processo bianco che riceve un marker fa lo stesso: salva lo stato, diventa rosso, invia i marker.
Lo stato di un canale sono i messaggi ricevuti su quel canale dopo essere diventati rossi e prima del marker su quel canale: messaggi inviati da un processo bianco e ricevuti da uno rosso, cioè in volo al momento della fotografia. Il marker chiude la registrazione di quel canale; il canale da cui arriva il primo marker è registrato vuoto.
Pi::  color := white;  chan[1..k] := code vuote;  closed[1..k] := false   -- k canali in ingresso

turn_red(), solo se color = white:
  save_local_state;  color := red
  send marker su tutti i canali in uscita

on marker dal canale j:
  if color = white then turn_red()
  closed[j] := true

on messaggio applicativo dal canale j:
  if color = red and not closed[j] then append(chan[j], messaggio)
  -- in ogni caso il messaggio viene elaborato normalmente
Grazie al FIFO, su ogni canale il marker separa i messaggi inviati prima della registrazione del mittente da quelli inviati dopo. Quindi nessun processo bianco riceve mai un messaggio inviato da un processo rosso: nessuno stato registrato contiene la ricezione di un messaggio il cui invio non è registrato, e gli stati locali sono concorrenti. Senza FIFO un messaggio post-snapshot potrebbe sorpassare il marker e finire nello stato sbagliato. Un processo ha finito la sua parte quando ha ricevuto il marker su tutti i canali in ingresso; raccogliere gli stati registrati in un unico snapshot è un passo successivo.
Sugli snapshot si costruiscono l'osservazione di predicati globali (lineari, regolari, congiuntivi, sui canali), il rilevamento di deadlock e di terminazione e il calcolo di funzioni globali.
7. Il consenso e il risultato FLP
Il consenso è il problema di mettere d'accordo processi distribuiti sul valore di una proprietà o su un'azione da compiere. È ovunque: decidere se fare il commit di una transazione, eleggere un leader, replicare una macchina a stati, il broadcast atomico, la sincronizzazione degli orologi, la blockchain. Molti problemi si possono riformulare come consenso, anche la mutua esclusione: tutti devono concordare su chi entra. Un algoritmo di consenso è quindi uno strumento generale, anche se gli algoritmi specifici (come Ricart–Agrawala) sono fatti su misura per il loro problema.
La definizione delle slide (Coulouris): ogni processo Pi parte nello stato undecided e propone un valore vi da un insieme D; i processi si scambiano valori; ognuno alla fine fissa una variabile di decisione di ed entra nello stato decided, dal quale non può più cambiarla. Un processo è corretto se non subisce guasti. I requisiti sono tre:
Terminazione: prima o poi ogni processo corretto fissa la propria variabile di decisione.
Accordo: tutti i processi corretti decidono lo stesso valore.
Integrità: se i processi corretti hanno proposto tutti lo stesso valore, ogni processo corretto che decide sceglie quel valore.
Senza guasti il problema è banale. Tre sensori misurano la temperatura: P1 e P2 propongono 1, P3 propone 2. Ognuno invia il proprio valore a tutti, ognuno si ritrova {1, 1, 2} e applica lo stesso criterio, per esempio la maggioranza: tutti decidono 1. Il problema nasce con i guasti. Se P2 invia il suo valore a P1 e poi cade prima di inviarlo a P3, P1 conosce {1, 1, 2} e P3 solo {1, 2}: con le stesse regole possono decidere diversamente.
Il risultato FLP
Fischer, Lynch e Paterson (1985): in un sistema asincrono, nessun algoritmo deterministico risolve il consenso se anche un solo processo può fermarsi per un crash. L'intuizione è la solita: un processo caduto è indistinguibile da uno lento. Se si aspetta il suo valore si rischia di aspettare per sempre, violando la terminazione; se si decide senza, lui potrebbe essere vivo, aver già influenzato qualcun altro e produrre un disaccordo. Ogni problema che si riduce al consenso eredita l'impossibilità.
Per uscirne bisogna cambiare le ipotesi. Le slide scelgono la strada della sincronia: se ritardi e tempi di esecuzione hanno un limite noto, un timeout rileva davvero un crash.
Oltre le slide
Le altre strade sono gli algoritmi randomizzati, che terminano con probabilità 1, e la sincronia parziale: Paxos e Raft (sezione 10) garantiscono sempre l'accordo e terminano quando la rete si comporta in modo abbastanza sincrono da stabilizzare un leader.
8. Consenso in un sistema sincrono
In un sistema sincrono si può assumere un limite superiore sul ritardo dei messaggi e sulla durata delle azioni dei processi. Bisogna poi dire quali guasti si tollerano. Le slide distinguono quattro modelli, dal più semplice al più difficile:
Modello
Che cosa può succedere
Crash
un processo si ferma e non fa più nulla
Crash + link
cade un processo oppure un collegamento; un collegamento caduto resta giù
Omissione
un processo invia solo una parte dei messaggi che dovrebbe, o ne riceve solo una parte
Bizantino
un processo ha un comportamento arbitrario
Per i crash l'algoritmo di base lavora a round. Ogni processo mantiene V, l'insieme dei valori proposti che conosce, e se f è il numero massimo di processi che possono cadere esegue f + 1 round. In ogni round invia a tutti i valori di V che non ha ancora inviato e raccoglie quelli degli altri; per la sincronia, chi non si fa sentire entro un tempo prefissato è considerato caduto. Alla fine tutti applicano la stessa funzione di decisione.
Pi::  V := { v[i] }
for k := 1 to f + 1 do
  send { v in V | Pi non ha ancora inviato v } a tutti
  receive Sj da ogni Pj, j != i        -- entro il timeout del round
  V := V ∪ Sj
y := decide(V)                          -- stessa funzione per tutti
Servono O((f + 1)·N²) messaggi. Il secondo round serve proprio a propagare ciò che un processo caduto ha fatto in tempo a dire solo ad alcuni. Nell'esempio dei sensori, con f = 1 e ogni valore accompagnato da chi l'ha proposto:
Dopo
P1 conosce
P3 conosce
round 1 (P2 invia solo a P1 e cade)
P1: 1, P2: 1, P3: 2
P1: 1, P3: 2
round 2 (P1 inoltra il valore di P2)
P1: 1, P2: 1, P3: 2
P1: 1, P2: 1, P3: 2
Con la stessa informazione e lo stesso criterio, P1 e P3 decidono 1. In generale, con al più f crash, in f + 1 round ce n'è almeno uno senza nuovi crash, e dopo quel round tutti i corretti hanno lo stesso insieme. L'algoritmo funziona solo senza comportamenti bizantini: un processo che invia valori diversi a destinatari diversi non si scopre con altri round.
La funzione decide va scelta con cura. Se è il minimo di V, il valore di un processo caduto può vincere anche quando tutti i corretti hanno proposto lo stesso valore: l'accordo resta garantito, l'integrità nella forma delle slide no.
9. Guasti bizantini
Un processo bizantino non si ferma: continua a partecipare ma dice cose false o contraddittorie, per esempio «il mio valore è 1» a un processo e «è 3» a un altro, per un bug o per malizia. È il caso più difficile, formulato da Lamport, Shostak e Pease (1982) come problema dei generali bizantini (Byzantine General Agreement, BGA): alcune divisioni di un esercito assediano una città e vincono solo se attaccano insieme; comunicano con messaggeri, e tra i generali ci sono traditori che cercano di far attaccare alcuni e ritirare altri. Il protocollo deve far sì che i generali leali (i processi corretti) prendano tutti la stessa decisione, attaccare o ritirarsi.
Il risultato fondamentale: non esiste un protocollo che tolleri f traditori se N ≤ 3f, dove N è il numero totale di processi. Servono quindi almeno 3f + 1 processi: con un traditore ne servono 4, con due 7. In altre parole, i traditori devono essere meno di un terzo.
L'algoritmo del re (phase king)
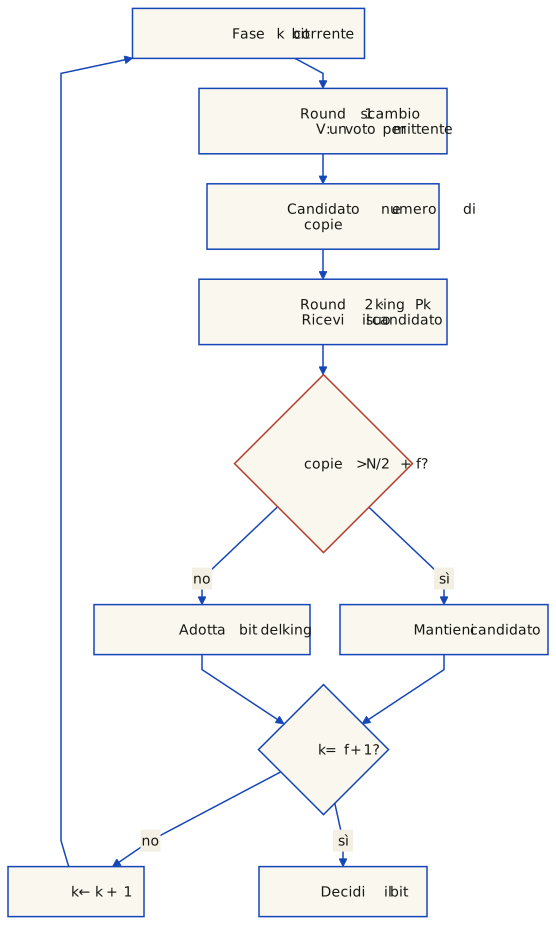
L'algoritmo delle slide esegue f + 1 fasi. In ogni fase un processo diverso fa da re (king): con f + 1 re distinti, almeno uno è leale. Ogni fase ha due round:
ognuno invia il proprio valore a tutti e, dal vettore V ricevuto, calcola il valore di maggioranza myvalue;
il re invia il proprio myvalue a tutti. Chi vede il proprio myvalue in più di N/2 + f copie lo mantiene; altrimenti adotta il valore del re (un valore di default se il re non invia nulla).
Pi::  V[1..N] := (V[i] = valore iniziale, gli altri indefiniti)
for k := 1 to f + 1 do
  -- primo round
  send V[i] a tutti;  V[j] := valore ricevuto da Pj
  myvalue := maggioranza di V
  -- secondo round
  if k = i then send myvalue a tutti          -- sono il re di questa fase
  kingvalue := valore ricevuto da Pk
  if V contiene più di N/2 + f copie di myvalue then V[i] := myvalue
  else V[i] := kingvalue
y := V[i]
La soglia fa funzionare le due situazioni. Nella fase di un re leale, chi non supera la soglia adotta il suo valore, e chi la supera ha la stessa maggioranza che vede anche il re: dopo quella fase i leali sono d'accordo. Nelle fasi successive ogni leale vede almeno N − f copie del valore comune, e se N − f supera N/2 + f lo mantiene, qualunque cosa dica un re traditore. Questa condizione equivale a N > 4f: la variante delle slide richiede quindi più processi del limite teorico 3f + 1, che altri algoritmi raggiungono.
Fig. 5 — Il flusso visto da un processo leale. Si decide solo dopo l'ultima fase.
Simulatore: soglia e re traditore
P2 è il traditore e fa da re nella seconda fase. Con N = 5 e f = 1 un re traditore non rompe un accordo già raggiunto, e un re leale risolve un disaccordo iniziale. Con N = 4, che soddisfa 3f + 1 ma non N > 4f, questa variante fallisce.
Il simulatore richiede JavaScript.
10. Paxos, Raft e macchine a stati replicate
Le slide chiudono con tre spunti, citati come approfondimenti.
Paxos (Lamport, The Part-Time Parliament, 1998) è una famiglia di protocolli per il consenso tra processori inaffidabili, con uno spettro di compromessi: numero di processori, numero di ritardi di messaggio prima di conoscere il valore concordato, attività dei singoli partecipanti, numero di messaggi, tipi di guasto. Si usa dove serve durabilità, per esempio per replicare un file o un database. Rispetto al BGA considera guasti non bizantini: processi che si fermano (e possono ripartire), non processi che mentono. È un caso più semplice.
Raft (Ongaro e Ousterhout, 2013–2014) è un algoritmo di consenso progettato per essere comprensibile. Distribuisce una macchina a stati su un cluster facendo in modo che tutti i nodi concordino sulla stessa sequenza di transizioni. Gli autori lo presentano come equivalente a Paxos per tolleranza ai guasti e prestazioni, ma più facile da capire e implementare; ne esistono implementazioni open source in Go, C++, Java e Scala.
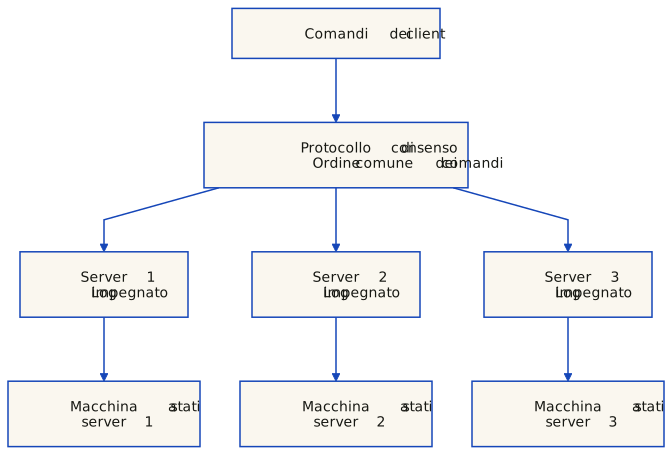
Il consenso compare tipicamente nelle macchine a stati replicate, lo schema generale per costruire sistemi tolleranti ai guasti. Ogni server ha una macchina a stati, il componente che si vuole rendere robusto (per esempio una tabella hash), e un log di comandi come «set x to 3». L'algoritmo di consenso serve a concordare il contenuto dei log: se una macchina applica «set x to 3» come n-esimo comando, nessun'altra applicherà un n-esimo comando diverso. Ogni macchina elabora così la stessa sequenza di comandi e attraversa la stessa sequenza di stati, e ai client il sistema appare come un'unica macchina a stati affidabile, anche se una minoranza dei server si guasta.
Fig. 6 — Prima l'accordo sull'ordine dei comandi, poi l'esecuzione. Le repliche possono essere a punti diversi del log, ma non eseguono mai comandi diversi nella stessa posizione.
Verifica le tue conoscenze
Quali sono le sfide e le ipotesi tipiche degli algoritmi distribuiti?
Mancano clock e memoria condivisi e ci sono guasti. Quasi tutti gli algoritmi assumono un sistema asincrono senza guasti; quando si gestiscono i guasti si assume la sincronia, per poter usare timeout affidabili.
Come funziona la mutua esclusione centralizzata e come ottiene la fairness?
Un coordinatore custodisce il token: richiesta, token, rilascio. Per servire le richieste secondo happened-before, ogni messaggio porta un vettore con il numero di richieste note di ogni processo; il coordinatore ritarda una richiesta finché tutte quelle che la precedono causalmente non sono state soddisfatte.
Come si realizza una sezione critica senza coordinatore?
Con Ricart–Agrawala: si chiede il permesso a tutti con una richiesta marcata (timestamp, id). Si risponde OK subito, tranne se si è in CS o si sta richiedendo con una coppia minore: allora l'OK si invia all'uscita. Si entra con N − 1 OK, 2(N − 1) messaggi in tutto.
Che cos'è un leader e come lo elegge Chang–Roberts?
Un processo scelto per un ruolo speciale, per esempio coordinatore. Su un anello logico ognuno inoltra il massimo id visto e sostituisce gli id minori con il proprio se non ha ancora partecipato; chi riceve indietro il proprio id è il massimo, si proclama leader e fa girare l'annuncio.
Che differenza c'è tra ordine FIFO, causale e totale dei messaggi?
FIFO: ordine di invio per ogni coppia mittente-destinatario. Causale: se un invio precede causalmente un altro, ogni destinatario comune li riceve in quell'ordine, anche con mittenti diversi. Totale: tutti ricevono i messaggi nello stesso ordine, indipendentemente dalla causalità.
Che cosa sono i pulse e i sincronizzatori?
Meccanismi per simulare una rete sincrona su una asincrona. Un pulse è un contatore per processo tale che i messaggi inviati al pulse i sono ricevuti al pulse i; il sincronizzatore dice a un processo quando può passare al pulse successivo.
A che cosa serve uno snapshot globale e che cos'è un taglio consistente?
A ricostruire uno stato globale coerente, per esempio per rilevare deadlock o terminazione. Un taglio è consistente se, quando contiene la ricezione di un messaggio, contiene anche il suo invio; i messaggi inviati e non ancora ricevuti formano lo stato dei canali.
Come funziona Chandy–Lamport?
Chi avvia salva il proprio stato, diventa rosso e invia un marker su ogni canale in uscita; chi riceve il primo marker fa lo stesso. I messaggi ricevuti su un canale dopo essere diventati rossi e prima del marker di quel canale sono lo stato del canale. I canali FIFO garantiscono che nessun bianco riceva messaggi da un rosso.
Esistono algoritmi di consenso per reti asincrone? E per reti sincrone?
In un sistema asincrono no, se anche un solo processo può andare in crash: è il risultato FLP, valido per ogni algoritmo deterministico. In un sistema sincrono sì: con al più f crash bastano f + 1 round di scambio dei valori noti.
Che cos'è il Byzantine General Agreement e quanti processi servono?
È il consenso quando i processi guasti possono comportarsi in modo arbitrario, anche mentendo. Non si può risolvere se N ≤ 3f: servono almeno 3f + 1 processi. L'algoritmo del re delle slide, con la sua soglia N/2 + f, richiede N > 4f.
Da quali lezioni viene questo capitolo
Slide [module-4.2] Distributed Algorithms – An Overview · 15 maggio 2026 (tutta la lezione: sfide e categorie, mutua esclusione centralizzata e Ricart–Agrawala, Chang–Roberts, ordinamento causale e sincronizzatori, snapshot di Chandy–Lamport, consenso, FLP, round sincroni, bizantini, Paxos e Raft) · 18 maggio (assignment 4, esercizio opzionale sulla sezione critica distribuita). La lezione dell'11 maggio, che il vecchio indice associava a questi temi, era dedicata al cluster di Pekko. La mappa completa è in coverage-matrix.json.